
همبستگی پیرسون و اسپیرمن؛ انتخاب، تفسیر و گزارش
پیرسون، شدت رابطهٔ خطی را خلاصه میکند؛ اسپیرمن، رابطهٔ یکنواخت را با رتبهها بررسی میکند. انتخاب میان آنها فقط با یک آزمون نرمالبودن انجام نمیشود. ابتدا شکل رابطه، مقیاس، دادههای پرت و ساختار مشاهدهها را ببینید؛ سپس مشخص کنید چه نوع رابطهای برای سؤال شما مهم است.
رابطهٔ خطی با رابطهٔ یکنواخت چه تفاوتی دارد؟
در رابطهٔ خطی، تغییر Y بهطور تقریبی با خط مستقیم نسبت به X توصیف میشود. در رابطهٔ یکنواخت، با افزایش X، مقدار Y در یک جهت حرکت میکند، اما مسیر میتواند خمیده باشد. یک رابطهٔ U شکل ممکن است قوی و منظم باشد ولی با هیچیک از این دو ضریب بهخوبی خلاصه نشود.
هر دو ضریب بین منفی ۱ و مثبت ۱ هستند. نزدیکشدن به صفر، نبود هر نوع رابطه را ثابت نمیکند. اگر یکی از متغیرها ثابت باشد، ضریب تعریف نمیشود؛ صفر گزارشکردن در این وضعیت اشتباه است.
چه زمانی کدام ضریب را بررسی کنیم؟
| وضعیت و سؤال | ضریب مطرح | کنترل لازم |
|---|---|---|
| دو متغیر عددی و علاقه به رابطهٔ خطی. | پیرسون. | نمودار، نقاط اثرگذار، ساختار نمونه و روش استنباط متناسب. |
| دادهٔ رتبهای یا علاقه به رابطهٔ یکنواخت که لزوماً خطی نیست. | اسپیرمن. | معنای رتبهها، رتبههای مساوی و شکل رابطه. |
| رابطهٔ خمیده و غیریکنواخت یا چند گروه متفاوت. | یک ضریب کلی ممکن است گمراهکننده باشد. | نمایش و مدلسازی شکل رابطه یا گروهها. |
| اندازهگیریهای تکراری از یک فرد یا دادهٔ خوشهای. | پیرسون/اسپیرمن ساده با استنباط مستقل کافی نیست. | روشی که وابستگی مشاهدهها را در طراحی و تحلیل لحاظ کند. |
برای محاسبهٔ خودِ r پیرسون، نرمالبودن یک شرط جبری نیست. فرضهای آزمون یا فاصلهٔ اطمینان را باید جداگانه بررسی کرد. اسپیرمن نیز از همهٔ مشکلهای داده مصون نیست؛ برای نمونه، رابطهٔ غیریکنواخت یا خطای ثبت با تبدیل به رتبه برطرف نمیشود.
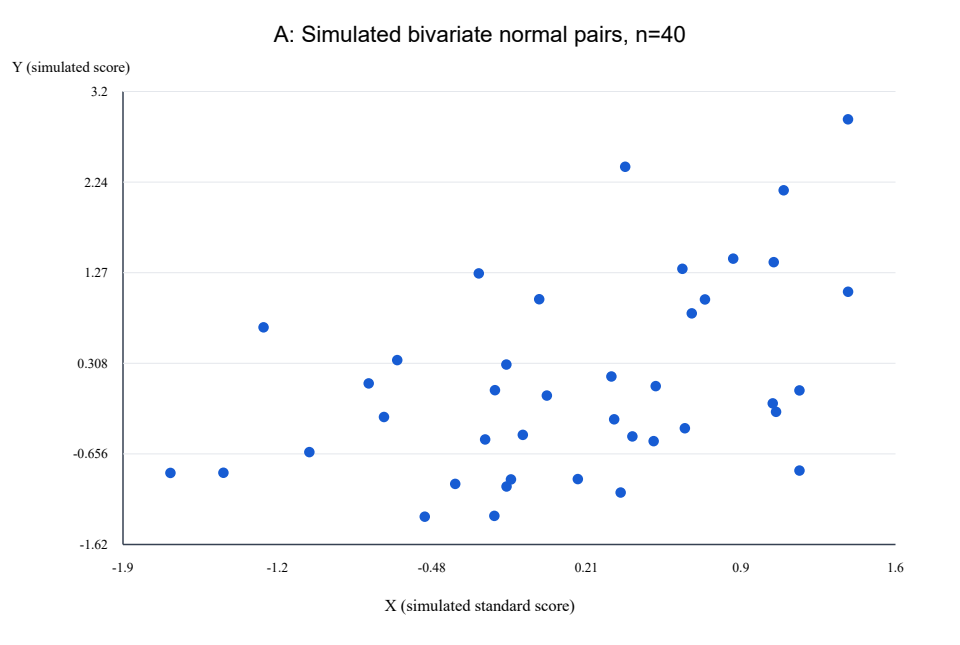
نمودار اول؛ نمونهٔ شبیهسازیشده با رابطهٔ خطی
دادهٔ آموزشی ساختهشده:۴۰ جفت مشاهده با مولد شبهتصادفی و بذر ۲۰۲۶۱۰۲۹ ساخته شدهاند. X و خطای مستقل، نرمال استانداردند و Y=0.6X+0.8ε است. این دادهها مشاهدهٔ واقعی کارکنان، بیماران یا سازمانی نیستند؛ برای بازتولید مثال تولید شدهاند.
دریافت ۴۰ جفت دادهٔ شبیهسازیشدهٔ مثال اول (CSV)
در همین نمونه، محاسبهٔ مستقیم فرمولها در Python نتیجه میدهد: r پیرسون≈۰٫۴۴۶ و ρ اسپیرمن≈۰٫۴۲۳. برای r، فاصلهٔ اطمینان تقریبی ۹۵ درصد با تبدیل فیشر حدود ۰٫۱۵۶ تا ۰٫۶۶۵ است. محاسبه از atanh(r)±1.96/√(n−3) و تبدیل معکوس انجام شده است؛ این فاصله به چارچوب جفتهای مستقل از توزیع نرمال دومتغیره متکی است.
نمونهٔ گزارش آموزشی: «در ۴۰ جفت دادهٔ شبیهسازیشده، رابطهٔ خطی مثبت با r=0.446 مشاهده شد؛ فاصلهٔ اطمینان تقریبی ۹۵ درصد فیشر[0.156,0.665] بود.» این گزارش، شاهدی دربارهٔ جامعهٔ واقعی یا تأثیر یک متغیر بر دیگری نیست. اینکه ضریب نمونه با مقدار ۰٫۶ در سازوکار تولید برابر نشده، نشان میدهد برآورد نمونه تغییرپذیر است.
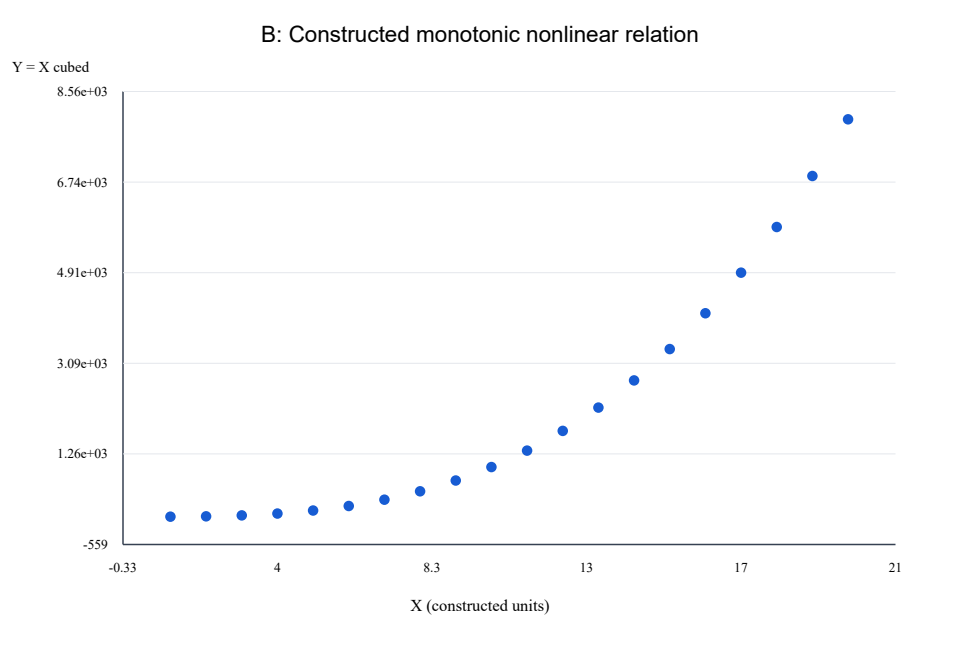
نمودار دوم؛ رابطهٔ یکنواخت ولی غیرخطی
در مثال دوم، X عمداً برابر اعداد ۱ تا ۲۰ و Y=X³ قرار داده شده است. همهٔ مقدارهای Y با افزایش X زیاد میشوند، اما شیب ثابت نیست. محاسبه میدهد ρ اسپیرمن=۱ و r پیرسون≈۰٫۹۲۲.
دریافت ۲۰ جفت مقدارِ ساختهشدهٔ مثال دوم (CSV)
اسپیرمنِ ۱ به معنی خط مستقیم نیست؛ در این مثال، رتبهها کاملاً همجهتاند. r بالا هم نباید خمیدگی واضح نمودار را پنهان کند. این ۲۰ نقطه یک نمونهٔ تصادفی از جامعه تعریف نشدهاند؛ برای آنها p یا فاصلهٔ اطمینانِ جامعه گزارش نمیکنیم.
عدمقطعیت و مقدار p را جداگانه بررسی کنید
ضریب، اندازه و جهت رابطهٔ موردنظر را توصیف میکند؛ p به فرض صفر، روش آزمون و طراحی وابسته است. p کوچک به معنی رابطهٔ بزرگ یا مهم نیست و p بزرگ، نبود رابطه را اثبات نمیکند. گزارش اندازهٔ نمونه، ضریب و فاصلهٔ اطمینانِ متناسب، از تکیه بر برچسب «معنادار» روشنتر است.
مستند SciPy برای p تقریبی اسپیرمن در نمونههای کوچکتر، بررسی آزمون جایگشتی را پیشنهاد میکند. این توصیه دربارهٔ روشِ استنباط است؛ محاسبهٔ ضریب رتبهای را با آزمون آن یکی نگیرید. در دادهٔ وابسته، بازآرایی دلخواه تکمشاهدهها نیز لزوماً مجاز نیست.
همبستگی از کجا به ادعای نادرست میرسد؟
عامل سوم، روند زمانی، انتخاب نمونه یا ترکیب گروهها میتواند رابطهٔ مشاهدهشده را توضیح دهد. از یک همبستگی دومتغیره نمیتوان نتیجه گرفت تغییر X باعث تغییر Y شده است. همچنین مقایسهٔ دو ضریب، فقط با نگاهکردن به بزرگی آنها یا معناداری جداگانهشان، آزمون اختلاف نیست.
در گزارش نهایی، نوع ضریب و دلیل انتخاب، تعداد جفتهای تحلیلشده، رسیدگی به دادهٔ گمشده، نمودار، روش فاصلهٔ اطمینان یا آزمون و حدود تعمیم را بنویسید. اگر رابطه خطی یا یکنواخت نیست، به جای انتخاب ضریبی که عدد بهتری میدهد، مدلی متناسب با سؤال بررسی کنید.
منابع
- SciPy community. SciPy 1.18.0 Manual؛ مستند pearsonr و spearmanr. بازبینی:۲۹ اکتبر ۲۰۲۶.
- American Statistical Association. (2016). Statement on Statistical Significance and P-Values.