
نرمالبودن دادهها؛ انتخاب و تفسیر شاپیرو–ویلک و کولموگروف–اسمیرنوف
برای بررسی نرمالبودن، ابتدا روشن کنید فرضِ روش آماری شما دربارهٔ چیست: توزیع متغیر در هر گروه، توزیع اختلافِ اندازهگیریهای زوجی یا خطاهای مدل؟ سپس نمودار و آزمون مناسب را در کنار هم بخوانید. یک مقدار p بهتنهایی نمیگوید تحلیل بعدی معتبر است یا باید روش را عوض کنید.
فرض نرمالبودن مربوط به کدام داده است؟
در آزمون t زوجی، توزیع اختلاف هر جفت مطرح است؛ بررسی جداگانهٔ دو ستون، همان فرض را نمیسنجد. در رگرسیون خطی با استنباط معمولِ مبتنی بر خطاهای نرمال، فرض به خطاهای شرطی مدل مربوط است و باقیماندهها برای تشخیص به کار میروند؛ لازم نیست توزیع تکتک متغیرهای پیشبین نرمال باشد. در مقایسهٔ گروهها نیز مخلوطکردن گروههایی با میانگین متفاوت میتواند نموداری گمراهکننده بسازد.
نرمالبودن فقط یکی از ملاحظات است. استقلال مشاهدهها، نوع مقیاس، دادهٔ پرت، شکل رابطه و فرضهای دیگر روش را نیز باید بررسی کرد. پاسخِ «داده نرمال است؟ » جای تعریف مدل و سؤال پژوهش را نمیگیرد.
نمودار Q–Q چه چیزی نشان میدهد؟
در نمودار Q–Q نرمال، مقدارهای مرتبشدهٔ داده با چندکهای نظری نرمال مقایسه میشوند. نزدیکبودن تقریبی نقاط به یک خط با سازگاری تقریبی با نرمال همراه است؛ خمیدگی منظم یا فاصلهٔ زیاد در دمها به بررسی بیشتر نیاز دارد. چند نقطهٔ نامنطبق در نمونهٔ کوچک، بهتنهایی حکم قطعی نمیدهد.
در کنار Q–Q، نمودار داده و اندازهٔ نمونه را ببینید. اگر داده متعلق به چند گروه یا زمان است، ساختار آن را در نمایش حفظ کنید. حذف نقطهٔ پرت فقط برای بهترشدن نمودار یا p مجاز نیست؛ خطای ثبت، سازوکار داده و تحلیل حساسیت را بررسی و تصمیم را گزارش کنید.
شاپیرو–ویلک و کولموگروف–اسمیرنوف چه تفاوتی دارند؟
| روش | فرض صفر و کاربرد | نکتهٔ تعیینکننده در تفسیر |
|---|---|---|
| شاپیرو–ویلک | بررسی سازگاری نمونه با توزیع نرمال؛ آماره W از رابطهٔ دادههای مرتبشده با ترتیبهای موردانتظار نرمال استفاده میکند. | p بزرگ اثبات نرمالبودن نیست؛ در مستند SciPy برای بیش از ۵۰۰۰ مشاهده دربارهٔ دقت p هشدار داده شده است. |
| کولموگروف–اسمیرنوف یکنمونهای استاندارد | مقایسهٔ توزیع تجربی با یک توزیع پیوستهٔ کاملاً مشخص. | اگر میانگین و انحراف معیار نرمال را از همین نمونه برآورد کردهاید، p و مقدارهای بحرانی نسخهٔ استاندارد قابلاستفادهٔ بیتغییر نیستند. |
| نسخهٔ اصلاحشده یا شبیهسازی متناسب | رسیدگی به وضعیتِ برآورد پارامترها از داده، با روش و پیادهسازی مشخص. | نام دقیق اصلاح، فرضها و نرمافزار را گزارش کنید؛ هر خروجی با برچسب K–S را یک آزمون یکسان ندانید. |
راهنمای NIST دربارهٔ K–S تأکید میکند که توزیع مرجع باید کاملاً مشخص باشد. بنابراین توصیهٔ «برای نمونهٔ کوچک شاپیرو، برای نمونهٔ بزرگ K–S» بدون توجه به برآورد پارامتر و هدف تحلیل، راهنمای کافی نیست.
یک مثال با داده و خروجی واقعیِ مستند
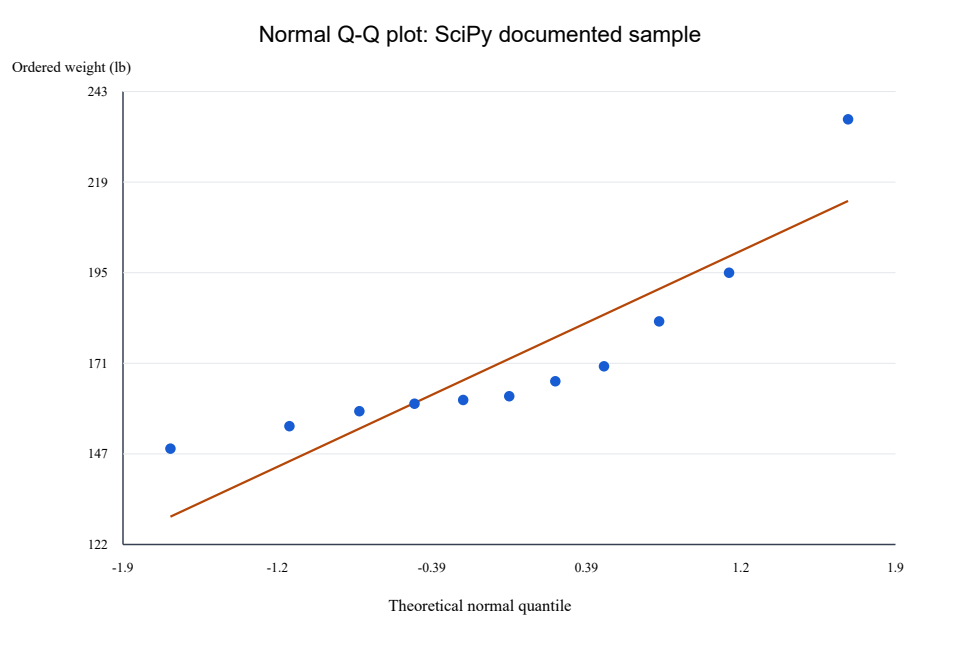
منشأ مثال: آموزش رسمی SciPy با عنوان Shapiro-Wilk test for normality این ۱۱ وزن را، با واحد پوند، فهرست کرده است: ۱۴۸، ۱۵۴، ۱۵۸، ۱۶۰، ۱۶۱، ۱۶۲، ۱۶۶، ۱۷۰، ۱۸۲، ۱۹۵، ۲۳۶. در این مقاله همان نمونهٔ مستند بازخوانی شده است؛ این اعداد دادهٔ تازهٔ گردآوریشدهٔ ما نیستند.
خروجی ثبتشده در مستند برای این داده،W=0.7888146948353875 و p=0.006703814056502984 است. این خروجی از صفحهٔ رسمی خوانده شده و اجرای تازهٔ SciPy در این مقاله نامیده نمیشود.
با سطحِ از پیش انتخابشدهٔ ۰٫۰۵، این p شواهدی علیه فرض صفر نرمالبودن میدهد. نتیجه نمیگوید «احتمال نرمالبودن داده ۰٫۶۷ درصد است»، علت انحراف را مشخص نمیکند و بهتنهایی روش تحلیل بعدی را تعیین نمیکند.
شرح نمودار آموزشی: نمودار Q–Q همراه این مثال از همین ۱۱ مقدار ساخته شده است. محور افقی چندک نرمال با موقعیت(i−0.5)/n و محور عمودی وزن مرتبشده است؛ خط مرجع از میانگین و انحراف معیار نمونه ساخته شده است. مقدار ۲۳۶ در انتهای بالا، بیش از دیگر نقاط از خط فاصله دارد. این مشاهده دلیل خودکار حذف آن نیست.
دریافت ۱۱ وزنِ مثال مستند، با واحد پوند (CSV)
p بزرگ و کوچک را چگونه بخوانیم؟
- p بزرگتر از آستانه یعنی با این آزمون و این داده، شاهد کافی برای رد فرض صفر نداریم؛ به معنی اثبات نرمالبودن نیست.
- در نمونهٔ کوچک، آزمون ممکن است بعضی انحرافها را تشخیص ندهد؛ نمودار و شناخت سازوکار داده را کنار نگذارید.
- در نمونهٔ بزرگ، انحراف کوچک نیز ممکن است آشکار شود؛ اهمیت آن برای برآورد و استنباط موردنظر را جداگانه بسنجید.
پس از بررسی نرمالبودن چه کنیم؟
اگر انحرافی دیده میشود، ابتدا معلوم کنید مربوط به کدام بخش مدل است و آیا خطای ثبت، چندگروهیبودن یا مدل نامناسب در آن نقش دارد. سپس متناسب با سؤال، روش مقاوم، تبدیلِ قابلتوجیه، مدل توزیعی مناسب یا روش بازنمونهگیری را بررسی کنید. تبدیل متغیر ممکن است معنای پارامتر و سؤال را تغییر دهد؛ آن را صرفاً برای عبور از آزمون انجام ندهید.
در گزارش بنویسید کدام متغیر یا باقیمانده، در چه گروهی و با چند مشاهده بررسی شد؛ کدام نمودار و آزمون، با چه پیادهسازی و اصلاحی استفاده شد؛ و این شواهد چه نقشی در انتخاب تحلیل داشتند. از جملهٔ تنها و مبهمِ «دادهها نرمال بود» پرهیز کنید.
منابع
- SciPy community. SciPy 1.18.0 Manual؛ Shapiro-Wilk test for normality و مستند توابع shapiro و kstest. بازبینی: ۲۹ اکتبر ۲۰۲۶.
- NIST/SEMATECH. e-Handbook of Statistical Methods؛ بخشهای Normal Probability Plot و Kolmogorov-Smirnov Goodness-of-Fit Test. بازبینی: ۲۹ اکتبر ۲۰۲۶.
- American Statistical Association. (2016). Statement on Statistical Significance and P-Values؛ اصول تفسیر p.